Claude Opus 5.5發布:日常表現對標Fable 5.1、成本較Opus 5降40% Terminal-Bench 66.4%登頂
Anthropic發布Claude 5.5家族首作Claude Opus 5.5(2026年9月22日)。官方稱其在大部分工作上達到Claude Fable 5.1的水平,而運行成本較Opus 5低40%。這是Anthropic呼籲「為前沿開發節奏」(pacing the frontier)後的首個發布,發布前經Frontier Design及METR等外部評測機構測試;在公司自有的自動化行為審計(迄今最全面的對齊測試)中,Opus 5.5是測試過表現最強的模型。
- Claude 5.5家族首作:大部分工作對標Fable 5.1水平,典型工作負載成本較Opus 5低40%
- 定價:輸入$4、輸出$20(每百萬token,較Opus 5平20%);快取讀取$0.20(平60%);輸出速度快30%以上
- Terminal-Bench 4.0得66.4%(Opus 5為52.3%);GDPval-AA達1846分
- 自動化行為審計創歷史最佳;Gray Swan提示注入測試與Fable 5.1並列最低
- Pro/Max/Team/Enterprise五小時用量上限提升;Sonnet 5.5與Haiku 5.5數週內登場
性能:68萬行代碼遷移一日完成
Anthropic稱Opus 5.5較Opus 5有重大提升,是新的領先模型。早期測試者在最複雜工作上見到大幅跳躍:一名測試者在一日內完成68萬行代碼遷移,相當於一個工程團隊數周的工作;在「縮短網頁應用各頁面載入時間」測試中,Opus 5.5在40次嘗試中成功39次,而Opus 5的改進幅度較小且改變了應用行為。另有測試者用單一提示讓多個Claude模型構建遊戲,Opus 5.5憑圖形與完成度勝出。
基準數據:agentic編碼領先 官方提醒分數參考性下降
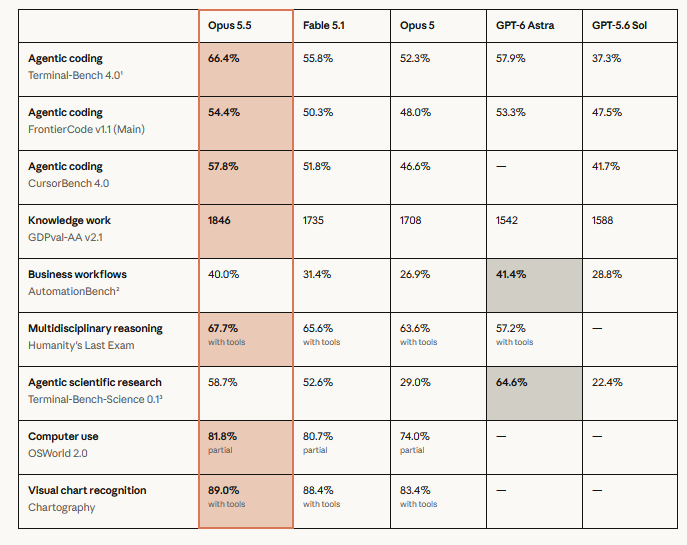
官方公布的對比(Opus 5.5/Fable 5.1/Opus 5/GPT-6 Astra/GPT-5.6 Sol):Terminal-Bench 4.0為66.4%/55.8%/52.3%/57.9%/37.3%;FrontierCode v1.1為54.4%/50.3%/48.0%/53.3%/47.5%;CursorBench 4.0為57.8%/51.8%/46.6%/41.7%(GPT-6 Astra未列);GDPval-AA v2.1為1846/1735/1708/1542/1588;AutomationBench為40.0%/31.4%/26.9%/41.4%/28.8%(此項GPT-6 Astra略高);HLE(with tools)為67.7%/65.6%/63.6%/57.2%;Terminal-Bench-Science 0.1為58.7%/52.6%/29.0%/64.6%(此項GPT-6 Astra更高);OSWorld 2.0(partial)為81.8%/80.7%/74.0%;Chartography(with tools)為89.0%/88.4%/83.4%。
官方同時提醒:在這水平上,基準分差已較少反映真實差距,自家實際使用中Opus 5.5與Fable 5.1的差距比分數窄。註釋亦披露,若生產防護介入,網絡安全任務由Claude Opus 4.8完成、生物學與前沿LLM開發任務由Claude Opus 5完成,這可能拉低Opus 5.5的基準分。
編碼實測:20萬行審計三小時、HAProxy移植快過Fable 5.1
早期測試者以Opus 5.5在三小時內審計並修復一個20萬行代碼庫,Opus 5則耗時逾20小時且多用2.5倍token。內部測試將流量平衡軟件HAProxy由C語言移植至Rust,Opus 5.5與Fable 5.1的改寫均通過幾乎全部回歸測試,Opus 5.5用時9.5小時(Fable 5.1為12小時),成本低51%。成本方面,FrontierCode默認effort下Opus 5.5以約每任務20%成本勝過GPT-6 Astra;Terminal-Bench 4.0以約40%成本追平Astra;CursorBench以約三分之一成本高出GPT-5.6 Sol 11分。
定價:輸入$4、輸出$20 快取讀取平60%
Opus 5.5服務所需算力低於Opus 5,典型工作負載下默認設置成本低40%。每百萬token定價:輸入$4、輸出$20(較Opus 5的$5/$25平20%);快取讀取$0.20(對比$0.50,平60%,而快取讀取佔agentic與編碼工作成本大頭);快取寫入$5(對比$6.25)。Claude Code及Claude Platform另設Fast mode,速度最高2.5倍,輸入$8、輸出$40。輸出速度較Opus 5快30%以上。
安全與合規:防注入並列最佳、保留思考防蒸餾
安全性上,Opus 5.5在自動化行為審計(數千個模擬場景)中取得迄今最佳成績,較近期模型更少作出難以逆轉的越界行為,對提示注入的抵抗力亦強於Opus 5;AI安全公司Gray Swan的測試中,其提示注入成功率與Fable 5.1並列受測模型最低。因其生物與網絡安全能力可比Claude Mythos 5.1,發布採用與Fable 5.1相似的防護:經核實機構可申請生命科學驗證計劃用於生物研究,網絡安全驗證計劃將於數週內擴大准入。
此外,Opus 5.5以「保留思考」(preserved thinking)機制啟動反蒸餾防護,阻止API用戶編改前文以抽取模型推理過程,適用於2026年8月31日或之後開立的API帳戶。模型提供零數據保留選項,並按歐盟AI法案實施水印措施,同時不再支援關閉「thinking」模式。
溝通風格、訂閱用量與後續發布
溝通方面,官方稱Opus 5.5行文更清晰、要點前置,早期測試者形容「它寫得像我一樣」,Anthropic指這既提升實用性亦是安全紅利。訂閱層面,Pro、Max、Team及按席次計費的Enterprise計劃五小時用量上限提升,並新增可儲存並隨時使用的限速重置額度。Kiro方面,其副總裁Deepak Singh表示在公開命令行基準上Opus 5.5解題數多於Opus 5、調用次數少約40%、token用一半,Kiro將於稍後接入。Claude Sonnet 5.5與Claude Haiku 5.5將於數週內推出。
資料來源:Anthropic官方發布